Quando l’AI smette di generare testo: Jev e PENSAI
Jev, PENSAI e la separazione tra linguaggio, valutazione e decisione nell’intelligenza artificiale
Di Salvatore Martino
20 settembre 2026- ore 10.25
Una nuova direzione dell’intelligenza artificiale
Un recente intervento di Simone Rizzo ha attirato la mia attenzione su Jev, il nuovo modello presentato da TypeSafe AI.
La questione non riguarda soltanto la velocità.
Jev viene presentato come un modello appartenente a una nuova categoria, definita da TypeSafe System One Models: sistemi progettati non principalmente per generare testo, ma per produrre decisioni strutturate che il software possa utilizzare direttamente. TypeSafe descrive Jev come una funzione nella quale entra uno stato non strutturato e vengono restituiti valori tipizzati, probabilità e confidence. (TypeSafe AI)
È una distinzione apparentemente tecnica.
In realtà introduce una domanda metodologica molto più ampia:
L’intelligenza artificiale deve necessariamente generare testo per poter valutare una situazione?
La risposta che emerge da Jev è no.
Ed è proprio qui che la questione incontra alcune riflessioni sviluppate attraverso PENSAI.
Simone Rizzo e la questione Jev
Nel suo approfondimento, Simone Rizzo mette in evidenza una caratteristica particolarmente interessante: Jev non nasce per conversare con l’utente.
Il modello riceve informazioni e istruzioni e restituisce direttamente una valutazione strutturata.
Non deve necessariamente scrivere:
«Considerando gli elementi disponibili, ritengo che…»
Può invece restituire una scelta, uno score o una probabilità.
Questo cambia il rapporto tra AI e software.
Un LLM generativo produce normalmente una sequenza di token. Se il risultato deve essere utilizzato da un programma, il software deve successivamente interpretare, estrarre o validare quella risposta.
TypeSafe propone invece un modello nel quale la struttura dell’output è definita a monte. Le possibilità dichiarate comprendono classificazione, routing, scoring, estrazione, branching e funzioni di verifica o guardrail. (TypeSafe AI)
Rizzo ha quindi individuato un fenomeno che merita di essere osservato non soltanto come novità di prodotto, ma come possibile cambio di paradigma architetturale.
Il passaggio fondamentale: dal testo alla decisione
Per comprendere la differenza possiamo semplificare due architetture.
Modello generativo
Stato → LLM → testo → interpretazione → software
Modello decisionale
Stato → modello → valutazione strutturata → software
Nel secondo caso il testo non scompare necessariamente.
Scompare la sua necessità come formato finale della valutazione.
È una differenza importante.
Il linguaggio naturale è estremamente potente per comunicare con gli esseri umani.
Non è necessariamente il formato più efficiente per comunicare una decisione a un altro programma.
Un software può avere bisogno semplicemente di:
ALLOW = false
oppure:
ROUTE = 3
oppure:
SCORE = 0,82
oppure:
CLASS = “high_risk”
La risposta linguistica può diventare superflua.
Una riflessione che riguarda anche l’italiano
Questo punto si collega direttamente a una riflessione sviluppata recentemente su OffLineMind riguardo alla scelta dell’italiano nell’interazione con l’AI.
La questione non dovrebbe essere formulata semplicemente come:
«Quale lingua comprende meglio l’intelligenza artificiale?»
La domanda più interessante è:
Quale funzione deve svolgere il linguaggio all’interno di un sistema di intelligenza artificiale?
Possiamo formulare un problema in italiano.
Possiamo descrivere lo stato di un sistema in italiano.
Possiamo formulare le istruzioni in italiano.
Un LLM può trasformare questa descrizione in una rappresentazione utilizzabile da altri componenti.
Ma il componente che effettua la valutazione non deve necessariamente produrre una risposta in italiano.
Può restituire direttamente una struttura computazionale.
Da qui emerge una distinzione:
lingua dell’interazione ≠ linguaggio della decisione
E questa distinzione è, a mio avviso, molto più interessante della semplice contrapposizione tra italiano e inglese.
Il linguaggio può essere un’interfaccia
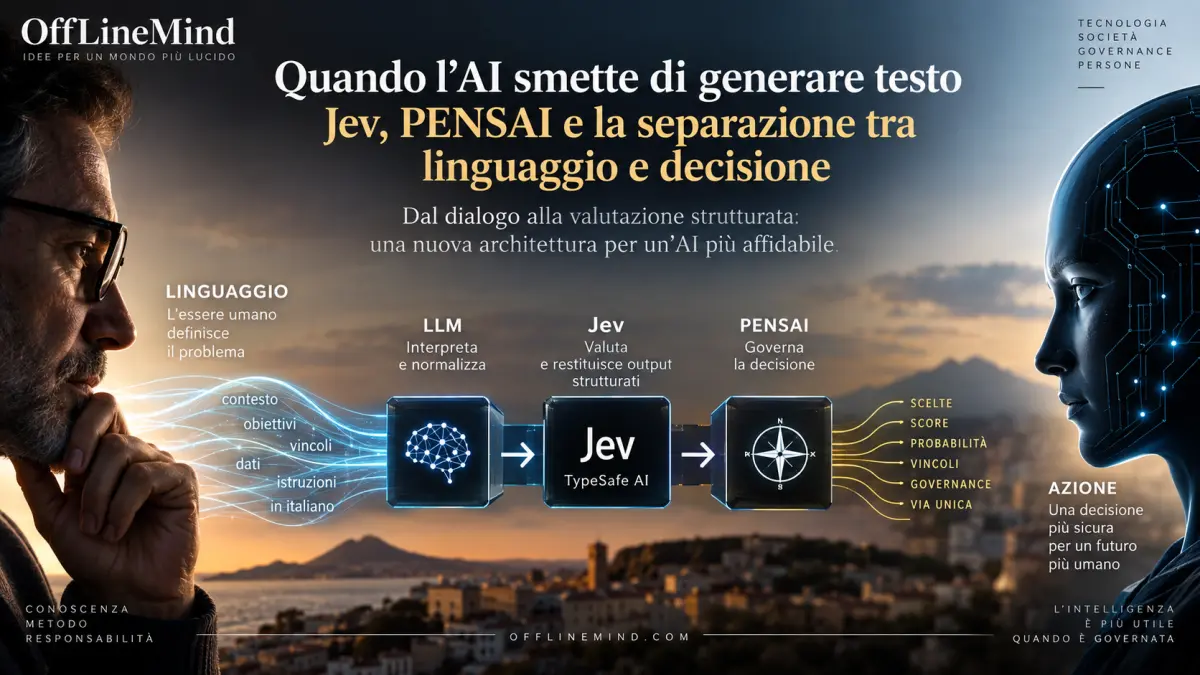
Possiamo quindi immaginare un’architettura:
Italiano
↓
definizione del problema
↓
normalizzazione dello stato
↓
istruzioni
↓
modello di valutazione
↓
score / probabilità / scelta
↓
governance
↓
decisione
In questo schema l’italiano conserva una funzione importante.
È il linguaggio con il quale l’essere umano può descrivere il problema.
Ma non deve necessariamente essere il linguaggio attraverso il quale la macchina realizza ogni fase successiva.
È una distinzione che permette di separare tre funzioni che spesso vengono confuse:
comprendere
valutare
decidere
Non sono sinonimi.
Jev non è PENSAI
Questa distinzione è necessaria.
Jev e PENSAI non sono la stessa cosa.
Jev è un modello tecnologico progettato per produrre valutazioni strutturate.
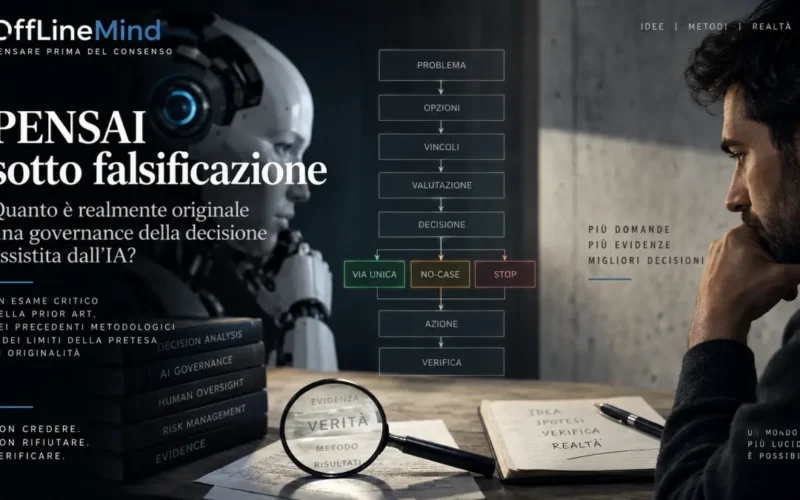
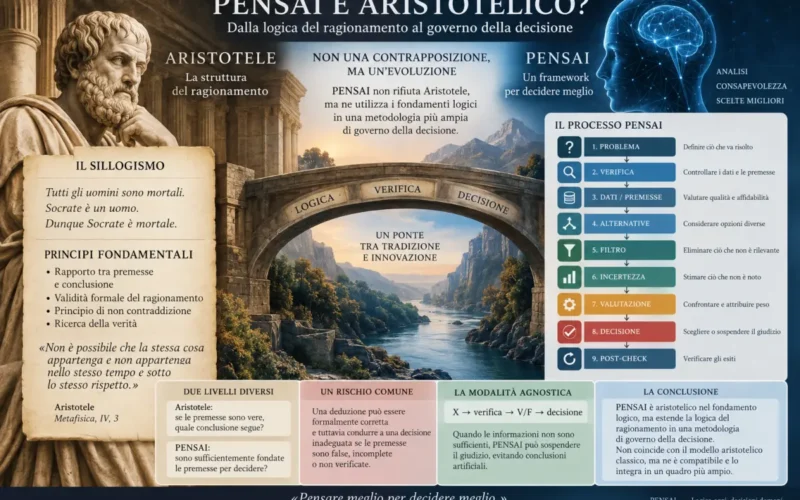
PENSAI è una metodologia di governance della decisione.
Il loro rapporto può quindi essere rappresentato così:
| Livello | Funzione |
|---|---|
| Linguaggio | Esprime il problema |
| LLM | Interpreta e normalizza |
| Modello specializzato | Valuta |
| AIDOM | Aggrega criteri e pesi |
| RISOLVO | Applica la pipeline decisionale |
| PENSAI | Governa la decisione |
| Supervisione umana | Interviene quando richiesta |
Non si tratta di stabilire quale componente sia “più intelligente”.
Si tratta di non chiedere a un unico componente di svolgere funzioni che possono essere separate.
Valutare non significa decidere
Qui emerge il punto che considero più importante.
Supponiamo che Jev restituisca:
SCELTA = B
CONFIDENCE = 0,91
Abbiamo una valutazione.
Non abbiamo necessariamente una decisione governata.
Perché?
Perché prima di trasformare quella valutazione in un’azione occorre sapere almeno:
- quale fosse lo stato iniziale;
- se lo stato fosse sufficientemente definito;
- quali fossero le alternative;
- quali criteri fossero applicabili;
- quali vincoli fossero presenti;
- quale soglia fosse richiesta;
- quale fosse il costo dell’errore;
- cosa accadesse in presenza di incertezza;
- quando fosse necessario coinvolgere un essere umano.
La velocità della valutazione non risolve queste domande.
Può renderne l’esecuzione molto più rapida.
Ma non le elimina.
Il problema della certezza
Questa distinzione diventa particolarmente importante quando si parla di affermazioni come “0% hallucinations”.
TypeSafe chiarisce nella propria documentazione che lo zero riguarda la type-safety, cioè la garanzia che l’output rispetti lo schema previsto. L’azienda precisa inoltre che il dato relativo allo schema matching non è una misura empirica dell’assenza di errori nella valutazione. (TypeSafe AI)
La distinzione è fondamentale.
Un sistema può garantire:
100% di conformità allo schema
senza garantire:
100% di correttezza della decisione.
Se un modello deve scegliere tra A, B e C, può essere impossibile produrre D.
Questo elimina un tipo di errore.
Non dimostra che A, B o C siano la risposta corretta.
La sicurezza del formato non coincide con la verità del contenuto.
Dalla generazione alla valutazione
Il percorso storico rende il fenomeno ancora più interessante.
Nel 2022 il lavoro su InstructGPT, al quale partecipò anche Diogo Almeida, affrontava il problema di rendere i modelli linguistici più capaci di seguire le intenzioni umane attraverso fine-tuning supervisionato e reinforcement learning from human feedback. (arXiv)
Jev parte da un problema differente.
Non chiede principalmente:
«Come facciamo a far scrivere meglio il modello?»
La domanda diventa:
«Come facciamo a trasformare l’intelligenza del modello in una funzione decisionale utilizzabile direttamente dal software?»
È una differenza concettuale importante.
TypeSafe presenta infatti RLCD, Reinforcement Learning for Calibrated Decisions, come parte della propria architettura di addestramento, con l’obiettivo dichiarato di ottenere decisioni accompagnate da probabilità calibrate. (TypeSafe AI)
Non significa che il problema sia risolto.
Significa che viene formulato diversamente.
La velocità cambia il problema
TypeSafe dichiara per Jev tempi di risposta nell’ordine di 70–500 millisecondi, oltre a un prezzo dichiarato di 0,042 dollari per milione di token di input. Sono dati pubblicati dall’azienda e devono quindi essere letti come benchmark e condizioni commerciali del fornitore, non come prestazioni universalmente dimostrate. (TypeSafe AI)
Una fonte indipendente ha riportato la stessa direzione generale, descrivendo Jev come un sistema destinato a classificazione, routing e altre decisioni rapide all’interno dei software, sottolineando al tempo stesso la necessità di verificare accuratezza e calibrazione in applicazioni reali. (UOL)
Ma la questione più interessante non è stabilire se Jev sia realmente 100 o 200 volte più veloce.
È capire cosa accade quando una valutazione AI diventa abbastanza economica e rapida da poter essere inserita ovunque.
In un router.
In un agente.
In un sistema di controllo.
In un workflow.
In un sistema di classificazione.
In migliaia o milioni di documenti.
La riduzione del costo dell’intelligenza può infatti aumentare enormemente il numero di decisioni automatizzabili.
Ed è proprio qui che la governance diventa più importante.
Più decisioni significa anche più errori potenziali
Un modello che valuta un documento al giorno pone un problema.
Un modello che valuta dieci milioni di documenti ne pone un altro.
La velocità amplifica la capacità operativa.
Ma amplifica anche l’eventuale errore sistematico.
Questo porta a una conseguenza metodologica:
Più una decisione automatizzata diventa economica e veloce, più diventa importante sapere quali condizioni ne autorizzano l’impiego.
La questione non è quindi soltanto:
quanto è accurato il modello?
È anche:
in quali condizioni è autorizzato a decidere?
Qui entra PENSAI
È esattamente questo il livello nel quale PENSAI può essere letto come complementare a modelli di questo tipo.
La funzione di PENSAI non consiste nel sostituire il modello che valuta.
Consiste nel governare il passaggio:
stato → valutazione → decisione
attraverso condizioni esplicite.
In termini semplificati:
LLM
interpreta.
↓
Jev / modello specializzato
valuta.
↓
AIDOM
calcola/aggrega.
↓
RISOLVO
applica la pipeline.
↓
PENSAI
verifica e governa.
↓
Via Unica
quando le condizioni lo consentono.
Questa architettura non pretende che un singolo modello sia contemporaneamente interprete, valutatore, decisore e autorità.
È una separazione funzionale.
E il ruolo dell’essere umano?
La questione non riguarda soltanto la tecnologia.
Il Regolamento europeo sull’intelligenza artificiale dedica l’articolo 14 alla sorveglianza umana dei sistemi ad alto rischio. Il testo stabilisce che tali sistemi devono essere progettati in modo da poter essere efficacemente supervisionati da persone fisiche e prevede, tra le altre cose, la capacità di interpretare l’output, ignorarlo o sovrascriverlo e interrompere il sistema quando necessario. Regolamento UE 2024/1689 — EUR-Lex
La lezione è importante:
automazione non significa necessariamente eliminazione della supervisione.
Un sistema può essere estremamente veloce e mantenere comunque condizioni di controllo.
Anzi, quando il numero delle decisioni aumenta, diventa necessario progettare il controllo insieme all’automazione.
Una possibile nuova architettura dell’AI
Da questa prospettiva possiamo immaginare una separazione sempre più netta:
1. AI linguistica
Comprende e produce linguaggio.
2. AI decisionale
Valuta stati e restituisce risultati strutturati.
3. AI di governance
Stabilisce condizioni, soglie, vincoli e gestione dell’incertezza.
4. Supervisione umana
Interviene quando il sistema non dispone delle condizioni necessarie per procedere autonomamente.
Non è detto che questa debba essere l’architettura definitiva.
Ma è una distinzione utile per comprendere ciò che sta accadendo.
Il possibile superamento della “chatbot economy”
Per anni l’interfaccia dominante dell’AI è stata la conversazione.
Scrivere una domanda.
Ricevere una risposta.
Fare una seconda domanda.
Ricevere una seconda risposta.
Ma una parte crescente dell’AI non sarà necessariamente utilizzata direttamente dagli esseri umani.
Sarà utilizzata da altri software.
Un agente potrà chiedere a un modello:
quale tool devo utilizzare?
Un workflow potrà chiedere:
questo documento appartiene alla categoria A, B o C?
Un sistema potrà chiedere:
devo interrompere questo processo?
Un altro:
questo output deve essere sottoposto a revisione umana?
In questi casi non serve necessariamente un paragrafo.
Serve una decisione strutturata.
È esattamente il territorio nel quale TypeSafe colloca Jev. (TypeSafe AI)
Non è la fine degli LLM
Sarebbe però un errore interpretare questa evoluzione come la fine dei modelli linguistici.
Al contrario.
Gli LLM rimangono particolarmente utili proprio dove il linguaggio è necessario:
- comprensione;
- sintesi;
- spiegazione;
- trasformazione;
- programmazione;
- dialogo;
- formulazione di istruzioni.
La possibile evoluzione consiste nella specializzazione dei componenti.
Non tutto deve essere generazione.
Non tutto deve essere classificazione.
Non tutto deve essere governance.
Un sistema complesso può utilizzare componenti diversi per funzioni diverse.
Una distinzione che diventa sempre più necessaria
Possiamo quindi arrivare a una formulazione molto semplice:
Generare non significa valutare.
Valutare non significa decidere.
Decidere non significa autorizzare l’azione.
Sono quattro funzioni differenti.
E confonderle può creare sistemi apparentemente intelligenti ma difficili da controllare.
Jev e PENSAI: due risposte diverse allo stesso problema
Jev pone una domanda tecnologica:
Come rendere l’intelligenza artificiale utilizzabile direttamente nei software per effettuare valutazioni rapide e strutturate?
PENSAI pone una domanda metodologica:
Come governare il percorso attraverso il quale una valutazione diventa una decisione?
Le due domande non sono in concorrenza.
Possono essere complementari.
Ed è proprio questa, probabilmente, la ragione per cui il lavoro di Simone Rizzo merita attenzione anche fuori dal semplice confronto tra modelli.
Conclusione
Il vero interesse di Jev potrebbe quindi non essere soltanto Jev.
Potrebbe essere l’idea che rappresenta.
Per molto tempo abbiamo associato l’intelligenza artificiale alla capacità di parlare.
Ora cominciamo a vedere sistemi progettati per valutare.
Il passaggio successivo non dovrebbe però essere confondere la valutazione con la decisione.
Una macchina può dire:
A: 0,87
Ma rimane una domanda:
È sufficiente per decidere?
La risposta dipende dallo stato, dal problema, dal rischio, dai criteri e dalle regole che governano il processo.
È qui che la questione tecnologica diventa una questione metodologica.
E qui si ritrovano Jev, la riflessione sul linguaggio e PENSAI:
il linguaggio può esprimere il problema;
un modello può valutarlo;
un sistema può trasformare la valutazione in un output strutturato;
una governance può stabilire se quella valutazione può diventare una decisione.
Forse la prossima fase dell’AI non sarà quindi soltanto quella di costruire macchine che parlano meglio.
Potrebbe essere quella di costruire sistemi nei quali parlare, valutare, decidere e agire siano finalmente funzioni distinte e verificabili.
Fonti
- Simone Rizzo, approfondimento su Jev e System One Models, settembre 2026. La sua analisi costituisce il punto di partenza di questa riflessione.
- TypeSafe AI, Introducing System One Models & Jev, 15 settembre 2026. Fonte primaria TypeSafe AI
- TypeSafe AI, documentazione generale sui System One Models e Jev. TypeSafe AI
- Ouyang et al., Training language models to follow instructions with human feedback, 2022, paper alla base di InstructGPT. Paper InstructGPT — arXiv
- Unione Europea, Regolamento (UE) 2024/1689 — AI Act, in particolare articolo 14 sulla sorveglianza umana. AI Act — EUR-Lex
Nota metodologica: le prestazioni, i costi e i confronti quantitativi di Jev riportati nell’articolo sono attribuiti a TypeSafe AI. La stessa società segnala che parte delle proprie valutazioni utilizza modelli esterni come riferimento e che alcuni risultati sono benchmark interni; non sono quindi presentati come benchmark indipendenti o conclusivi. (TypeSafe AI)
Disclaimer AI: questo articolo è stato elaborato con il supporto dell’intelligenza artificiale; le fonti citate sono state utilizzate per verificare i riferimenti tecnici e distinguere le dichiarazioni del produttore dalle considerazioni metodologiche.
Views: 6